

英伟达发布四款韩国开放模型的 Dynamo 配方,称性能最高可提升 2 倍
这些部署配方涵盖 SK电信、LG AI研究院、Upstage 和 Motif Technologies 的模型。英伟达表示,这些配方针对 B200 GPU 进行了优化,旨在简化部署并加快投入生产的进程。
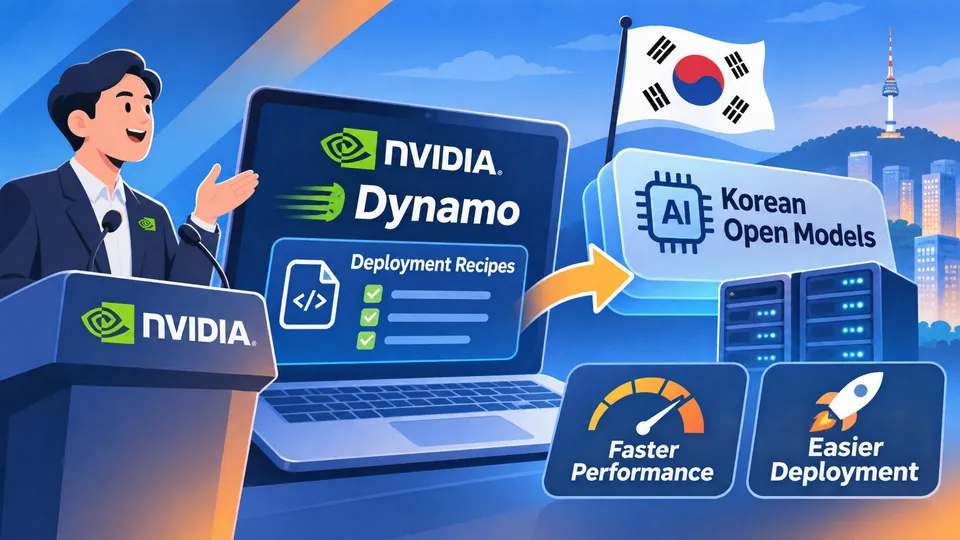
NVIDIA将为A.X K2、K-EXAONE 2.0、Solar Open 2和Motif-3发布部署配方。1
NVIDIA称这些配方开箱即用的性能最高可达2倍。1
这些配方针对NVIDIA B200 GPU进行了优化。1
经过
英伟达的 Dynamo 配方带来了哪些变化英伟达正为四款领先的韩国开放模型发布经 Dynamo 优化的部署配方,这套指导方案旨在帮助开发者使用英伟达的服务框架部署这些模型。1 这些配方针对英伟达 B200 GPU 进行了优化,英伟达表示,开箱即用时性能最高可提升 2 倍。1 这一性能数字是英伟达所称的上限,并非对每次部署的保证;该公司将这些配方描述为无需额外摸索即可使用。1 因此,核心变化并不是推出了一个新命名的模型,而是为现有模型提供了一套部署配方;英伟达将其定位为帮助这些模型更快投入生产的途径。1
英伟达列出的四款模型是 A.X K2、K-EXAONE 2.0、Solar Open 2 和 Motif-3。1 A.X K2 来自 SK电信,而 K-EXAONE 2.0 由 LG AI研究院开发。1 另外两款分别是 Upstage 的 Solar Open 2 和 Motif Technologies 的 Motif-3。1 这些对应关系表明,此次发布涵盖了与四家不同机构相关的模型;公告没有提供各模型的对比性能数据。1
分布式推理服务要解决的技术问题是:当模型过大、无法由单个 GPU 的容量承载时,必须将其拆分到多个 GPU 上。1 这种拆分会带来协调工作:必须对请求进行路由,并让 GPU 相互通信,才能维持性能。1 在这种情况下,部署配方的重要之处在于,它涉及如何通过硬件提供模型服务,而不是改变所提供服务的模型。1 英伟达的公告没有提供请求路由和通信这两项独立任务的测量数据;其公布的性能说法针对整体配方,最高可达 2 倍。1
英伟达将 Dynamo 描述为一个用于分布式推理服务的开源框架。1 该框架旨在数据中心规模的环境中跨多个节点部署模型。1 Dynamo 负责路由请求以及服务系统各部分之间的通信,其既定目标是最大限度地提升推理性能。1 这些功能对应着模型分布在多个 GPU 上时产生的协调需求,但公告没有单独提供数字来衡量 Dynamo 对配方性能说法的贡献。1
英伟达表示,这些配方可以免去部署过程中的摸索,并将其描述为对使用相关模型的开发者的实用支持。1 该公司还表示,这些配方可以帮助开发者更快地让韩国的开放模型投入生产。1 这是此次发布所声明的目的,而非报告的时间对比:现有公告没有提供使用配方前后的部署时长。1 同样,最高可达 2 倍的数字是一项性能说法,而现有事实中的公告没有说明各模型的具体结果或测量程序。1
与所涉模型相关的开发者包括 SK电信、LG AI研究院、Upstage 和 Motif Technologies。1 英伟达在介绍中称,开发者可能会使用这些配方让模型投入生产;公告还将 AI 服务惠及更广泛人群描述为一种可能的结果。1 英伟达表示,这些配方有助于将模型转化为广泛可用的“AI for All”服务,但没有量化届时的用户或服务数量。1 因此,公告明确了模型及其开发者,但没有说明最终部署或服务覆盖范围。1
公告所述的硬件目标是英伟达 B200 GPU,英伟达将其列为配方的优化平台。1 这一规格不同于“有些模型可能超出单个 GPU 的容量”这一说法:后者描述的是一般性的服务限制,并不意味着所有列出的模型都需要如此部署。1 当模型确实超出单个 GPU 的容量时,所述需求是将其分布到多个 GPU 上,并协调路由和通信。1 公告没有说明四款模型中任何一款需要多少个 GPU,因此,不应将配方针对 B200 的优化解读为已披露各模型所需的硬件数量。1
结构
谁和谁连在一起- 1NVIDIA Dynamo
- ← 使用事实
- 支撑 →事实
- 依赖 →事实
- 支撑 →事实
- 使用 →事实
影响
一层一层往外传来源
每个来源支撑了哪些内容本文由 AI 依据下方列出的来源撰写:每条事实都逐字核对过原文,推测与分析单独标注。 我们怎么写